
1. 1. Resumo
Todo scraper que aceita uma URL de um cliente externo carrega o mesmo risco embutido: em algum momento, o servidor vai buscar aquele conteúdo por conta própria. É nesse ato de buscar que mora o problema. A vulnerabilidade se chama Server-Side Request Forgery, SSRF, e ela não aparece nos testes de unidade nem nos logs de erro comuns. Aparece quando alguém descobre que pode transformar seu backend num proxy para dentro da sua própria rede. Este artigo examina por que a validação sintática de URLs falha, como a resolução DNS abre uma janela de corrida que poucos times enxergam, e o que realmente funciona na prática: resolução síncrona, bloqueio de faixas privadas em nível de IP e isolamento físico do processo que faz as requisições.
2. 2. A anatomia do risco em motores de extração de dados
Um scraper típico recebe uma URL, busca o conteúdo remoto e devolve dados tratados. Simples na superfície. O problema é onde esse código roda: dentro de uma rede que tem acesso a coisas que o cliente externo jamais deveria tocar.
Redis, bancos de dados internos, painéis administrativos, o endpoint de metadados da AWS em 169.254.169.254. Todos esses serviços confiam em requisições que partem de dentro da própria infraestrutura, sem exigir autenticação extra, porque presumem que só código interno consegue alcançá-los.
Quando o scraper aceita uma URL arbitrária e dispara a chamada HTTP sem isolamento, ele quebra essa premissa. Um atacante fornece um endereço apontando para a malha privada, e o servidor - que tem acesso - faz o trabalho sujo por ele. A falha não está na biblioteca HTTP escolhida nem no parser de HTML. Está na ausência de uma fronteira rígida entre "URL fornecida por estranho" e "conexão de rede que o servidor está prestes a abrir".
3. 3. O mecanismo cego de validação e as brechas na resolução DNS
O erro mais comum: validar a URL como string antes de conectar, e parar por aí. Regex, funções de parse nativas, checagem contra uma lista de domínios permitidos. Tudo isso analisa o texto. Nada disso olha para onde a conexão TCP realmente vai pousar.
Um atacante contorna esse tipo de filtro sem esforço. Notação hexadecimal (0x7f000001), octal (0177.0000.0001), inteiro de 32 bits (2130706433), encurtadores de link que escondem o destino real até o clique. Qualquer um desses formatos passa por uma regex ingênua e chega intacto ao resolvedor DNS do sistema operacional.
Mas o ataque mais sério é outro: DNS Rebinding. O atacante controla um domínio que responde com um IP público legítimo na primeira consulta, a que a aplicação usa para validar. A checagem passa. Só que a biblioteca HTTP dispara uma segunda consulta DNS, independente, para de fato abrir o socket - e nessa segunda resposta o servidor do atacante devolve um IP privado, tipo 10.0.0.1. A aplicação validou um endereço seguro na memória. A conexão real foi para outro lugar.
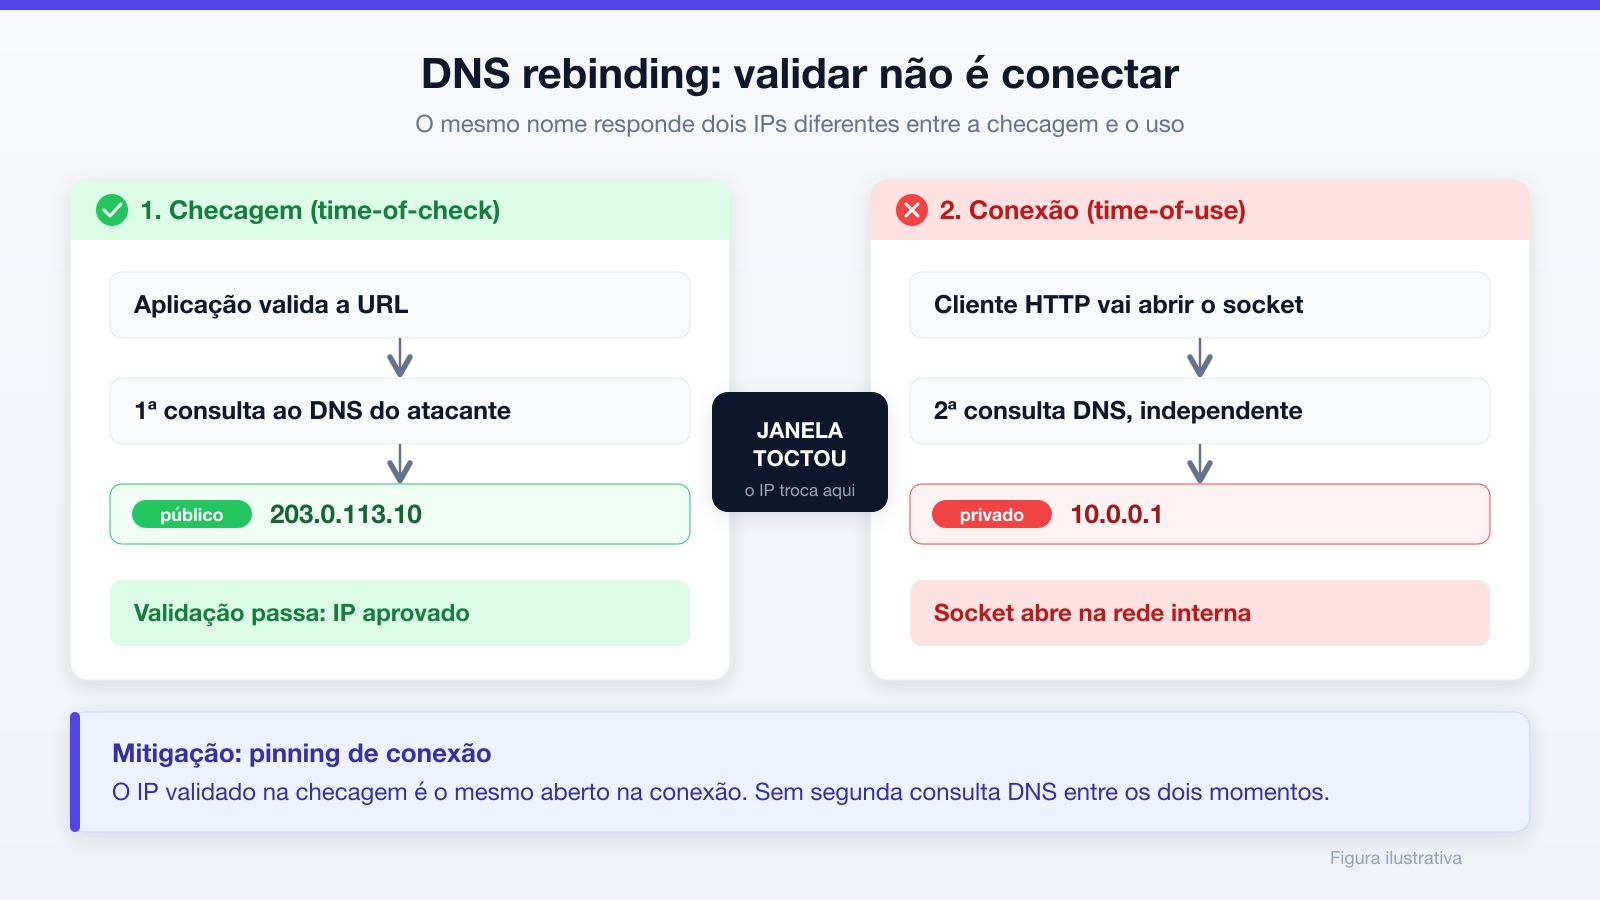
Esse é um TOCTOU clássico - time-of-check to time-of-use - só que aplicado à resolução de nomes. O que você checou (o IP da primeira consulta) e o que você usou (o IP da segunda) são coisas diferentes, e a janela entre os dois é exatamente onde o atacante mora. Nomear o padrão ajuda: sempre que a verificação e o uso de um recurso acontecem em momentos separados, e o recurso pode mudar no meio do caminho, você tem um TOCTOU. Rebinding é a versão dele que usa o DNS como ponto de troca.
A única mitigação que fecha essa corrida é o pinning de conexão: usar o mesmo IP validado na primeira resolução para abrir o socket, sem disparar uma segunda consulta DNS entre a checagem e a conexão. Resolver duas vezes não resolve nada; só reduz a chance de exploração, não a elimina. Fechar a janela do TOCTOU significa colapsar checagem e uso no mesmo IP - não há meio-termo.
4. 4. O mito da sanitização em nível de aplicação
Existe uma crença espalhada de que filtrar query strings ou cabeçalhos resolve o problema. Remover parâmetros de rastreamento como utm_source é bom para privacidade e para a higiene dos dados capturados. Contra SSRF, não faz nada.
A sanitização trabalha em cima do conteúdo da URL. O SSRF explora o destino físico da conexão. São camadas diferentes. Uma chamada HTTP feita pelo backend usa a stack de rede do sistema operacional para converter o host em IP e abrir uma porta TCP - se a aplicação mexer nos parâmetros mas deixar o host resolver para uma interface privada, a requisição atravessa a infraestrutura inteira sem obstáculo nenhum.
Redirecionamentos são outra falha clássica. A aplicação valida a URL inicial, confirma que pertence a um marketplace legítimo, libera a chamada. Só que se o destino responder com um Location apontando para um serviço interno, e o cliente HTTP seguir redirects automaticamente sem revalidar o destino final, todo o controle de acesso vira decoração.
5. 5. Estratégias de defesa em profundidade e mitigação arquitetural
Neutralizar SSRF sem destruir a performance do scraper exige camadas complementares: validação de rede, controle do cliente HTTP e isolamento de ambiente.
A primeira camada resolve o DNS de forma síncrona, imediatamente antes de disparar a requisição, e valida cada IP retornado contra os endereços de uso especial (RFC 1918 para redes privadas, RFC 3927 para link-local, e o registro consolidado da IANA mantido pelas RFCs 6890 e 8190, mais os endereços de metadados de nuvem). Uma observação de rigor: se você ainda referencia a RFC 5735 numa base de código, atualize - ela foi obsoletada pela 6890, que é a fonte viva hoje. Qualquer IP fora do espaço público interrompe a requisição antes de o socket TCP sequer abrir.
Isso vale para IPv6 também. Faixas como fc00::/7, fe80::/10 e ::1 precisam do mesmo bloqueio rígido - e o mesmo vale para endereços IPv4 mapeados em IPv6, tipo ::ffff:127.0.0.1, um formato que blocklists escritas só para IPv4 costumam esquecer. É um bypass conhecido e ainda funciona em muita implementação por aí.
A segunda camada trata redirecionamentos: desativar o follow automático no cliente HTTP, ou inspecionar cada URL de destino individualmente antes de seguir para a próxima chamada da cadeia.
A terceira camada isola o processo fisicamente. O worker que faz chamadas HTTP externas fica num segmento de rede próprio - DMZ ou subnet isolada - sem rota de volta para a rede corporativa. Firewall configurado em nível de sistema operacional (iptables, nftables) e proxy de saída controlado garantem que, mesmo se a aplicação falhar, o pacote seja barrado na própria interface do servidor.
O detalhe que costuma escapar é que nenhuma dessas camadas cobre tudo sozinha. Cada uma para uma classe de ataque e deixa outra passar - por isso elas se empilham em vez de competir. O mapa abaixo deixa isso explícito: use-o para não cair na armadilha de achar que uma allowlist de host, sozinha, resolveu o problema.
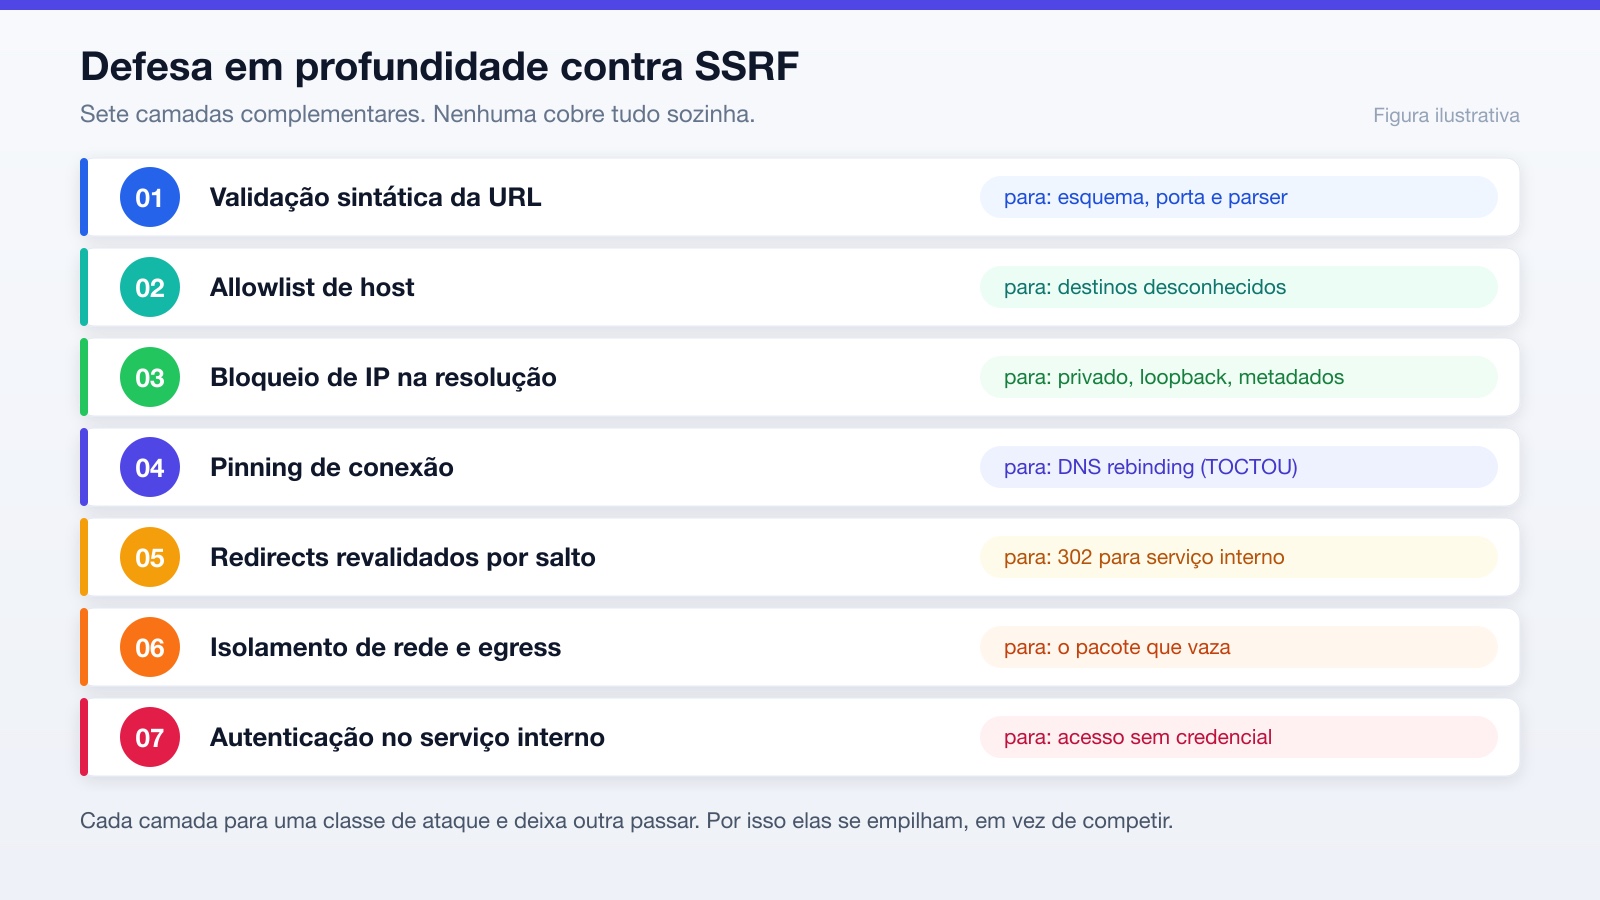
| Camada de defesa | O que ela para | O que ela não para |
|---|---|---|
| Validação sintática da URL (parser, esquema, porta) | Esquemas perigosos (file://, gopher://), portas fora da política, URLs malformadas | Qualquer host que resolva para IP privado; notações numéricas que o parser aceite; rebinding |
| Allowlist de host | Destinos totalmente desconhecidos | Rebinding (o host está na lista, o IP é que troca); um host permitido que sofra open redirect ou seja comprometido |
| Bloqueio de faixas de IP na resolução | Loopback, redes privadas, link-local, metadados - em IPv4 e IPv6 | Um destino público malicioso (canário de exfiltração, tarpit); rebinding, se você resolver de novo na hora de conectar |
| Pinning de conexão (IP validado = IP conectado) | DNS rebinding / o TOCTOU da resolução | Um IP público que já era malicioso na primeira consulta; redirects para destino interno |
| Redirects desligados / revalidados por salto | 302 Location: apontando para serviço interno após uma URL inicial legítima | Nada, se o follow automático continuar ligado por engano numa atualização de lib |
| Isolamento de rede + egress controlado (DMZ, iptables/nftables) | O pacote que vaza quando todas as camadas de aplicação falham | Exfiltração para destinos públicos que a política de egress permita |
| Autenticação no serviço interno | O acesso não autenticado que o SSRF presume conseguir | Serviços que confiam cegamente na origem de rede (é justamente o que você precisa corrigir) |
A leitura de cabeça: allowlist de host não para rebinding, bloqueio de IP não para destino público malicioso, pinning não para um IP que já nasceu ruim. Nenhuma linha da tabela é redundante - é por isso que a defesa é em profundidade, e não uma escolha entre camadas.
6. 6. Riscos operacionais, efeitos colaterais e custos de infraestrutura
Controles rigorosos de SSRF custam algo. Principalmente latência e portas TCP consumidas no servidor de aplicação.
Resolver o DNS manualmente antes de cada requisição adiciona latência - quanto, depende inteiramente da sua infraestrutura. Sem um resolvedor local eficiente por trás (Unbound ou BIND no próprio host, por exemplo) e sem cache aquecido, cada análise de URL paga o preço de round-trips de rede que uma resolução direta pela stack do SO muitas vezes já teria em cache. Não vou fingir um número aqui, porque ele varia com o resolvedor upstream, a rede e o padrão de acesso: meça no seu ambiente antes e depois de mover a resolução para dentro da aplicação. O que dá para afirmar sem chute é a direção - você troca um pouco de latência por controle sobre qual IP entra na conexão, e esse é um trade-off que quase sempre vale a pena num scraper que aceita URL de terceiro.
Esse cache, porém, precisa respeitar o TTL retornado pelo servidor autoritativo à risca. Um TTL estendido artificialmente reabre a mesma janela de corrida do DNS Rebinding descrito na seção 3, só que deslocada para dentro da própria infraestrutura - você fecharia o TOCTOU na aplicação e o reabriria no cache. Ironia que não compensa.
Timeouts mal configurados são outro risco, esse de negação de serviço. Um atacante que envia links para servidores lentos, ou tarpits deliberados, prende threads do PHP-FPM ou workers de fila esperando resposta - e exaure o pool de conexões do backend. A dica prática: trate os timeouts como tetos agressivos, não como folga. Algo na ordem de 1,5 segundo para conexão e 3,0 segundos para resposta é um ponto de partida razoável para um scraper - valores máximos, não alvos, e você aperta ou afrouxa conforme o perfil real dos destinos legítimos. O erro clássico é deixar o default da biblioteca (que costuma ser generoso ou infinito) e descobrir o problema só quando o pool já está no chão.
7. 7. Na prática, o que fazer? Critérios de decisão e padrão de implementação defensiva
Ao desenhar uma API de análise ou raspagem de links de terceiros, alguns critérios entram na base da arquitetura, não como extra.
Resolução síncrona com validação de IP em nível de socket: nenhuma chamada HTTP dispara direto da URL do cliente sem checar antes os endereços resolvidos.
Limite de payload nas requisições JSON de entrada, de 8 KB a 16 KB, para evitar exaustão de memória com strings arbitrárias.
Rate limiting por IP de origem no gateway ou na camada de rotas - 60 requisições por minuto é um ponto de partida razoável - para impedir mapeamento sistemático de portas internas via o próprio scraper.
E desativar qualquer esquema diferente de http e https. file://, gopher://, dict://, ftp:// - tudo isso barrado na camada de DTO ou FormRequest, antes mesmo de chegar perto da lógica de negócio.
Numa stack Laravel, a validação pós-resolução começa assim: filter_var($ip, FILTER_VALIDATE_IP, FILTER_FLAG_NO_PRIV_RANGE | FILTER_FLAG_NO_RES_RANGE) aplicado a cada endereço que dns_get_record retorna, antes de instanciar o client Guzzle, com allow_redirects desligado por padrão. Se precisar seguir redirect, revalida na mão.
Só que aqui mora uma armadilha que vale confessar em voz alta: validar o IP com dns_get_record e depois entregar o host para o Guzzle não implementa o pinning que a seção 3 prega. O Guzzle (via libcurl) vai resolver o nome de novo na hora de abrir o socket - uma segunda consulta DNS, independente da que você validou. É exatamente a janela do rebinding, reaberta pelo próprio código que achava estar fechando. Validar um IP e conectar num nome é validar uma coisa e usar outra.
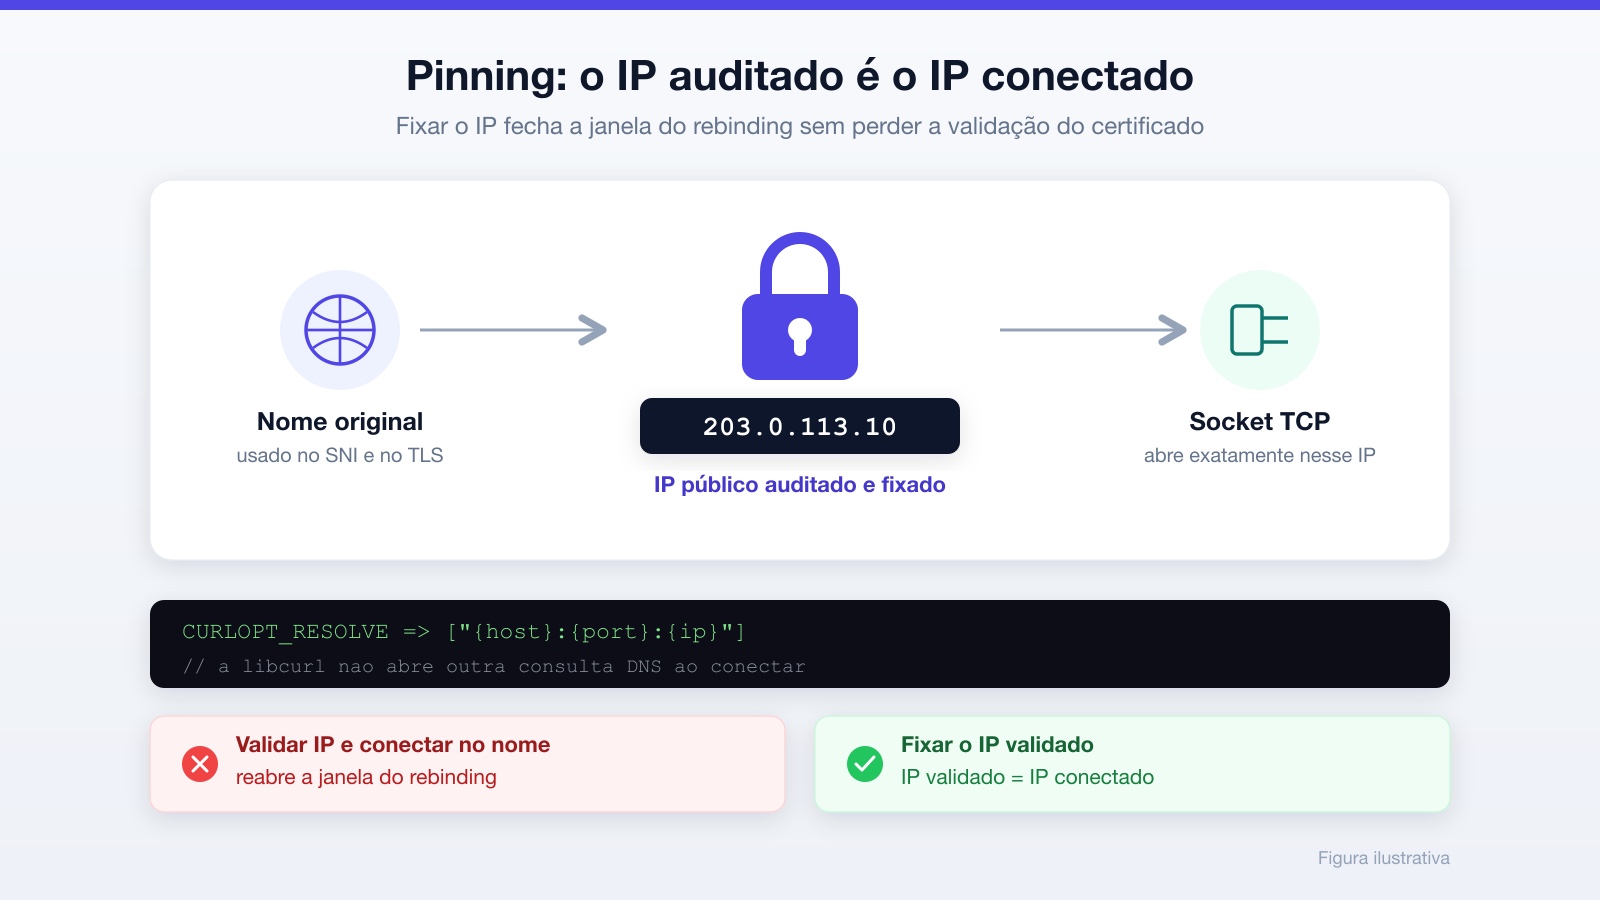
O pinning de verdade força a conexão a usar o IP que você auditou, mantendo o nome original só para SNI e validação do certificado TLS. Em cima de libcurl, isso é o CURLOPT_RESOLVE:
use GuzzleHttp\Client;
use GuzzleHttp\RequestOptions;

// $host, $port e $ip vêm da SUA resolução já validada (todos os A/AAAA checados).
// $ip é um endereço público aprovado; o nome original é preservado para SNI/TLS.
$client = new Client([
    RequestOptions::ALLOW_REDIRECTS => false, // redirect é uma nova requisição: revalida na mão
    RequestOptions::TIMEOUT         => 3.0,   // teto de resposta
    RequestOptions::CONNECT_TIMEOUT => 1.5,   // teto de conexão
    'curl' => [
        // Fixa o destino: "host:porta:ip" - a libcurl NÃO faz nova consulta DNS.
        CURLOPT_RESOLVE       => ["{$host}:{$port}:{$ip}"],
        // Mantém a verificação estrita do certificado contra o NOME, não contra o IP.
        CURLOPT_SSL_VERIFYPEER => true,
        CURLOPT_SSL_VERIFYHOST => 2,
    ],
]);

$response = $client->get("https://{$host}:{$port}/caminho");
A chave é a linha do CURLOPT_RESOLVE: ela diz à libcurl "quando for conectar em $host:$port, já sei o IP, use este e não pergunte ao DNS de novo". O IP auditado e o IP conectado passam a ser, por construção, o mesmo. O nome continua indo no SNI e na validação TLS, então você não perde a garantia do certificado. Sem essa linha, todo o trabalho de validação anterior vira teatro.
O caminho mais eficiente não começa por uma plataforma de segurança complexa. Começa por reduzir a superfície de ataque: decidir se o sistema realmente precisa buscar uma URL arbitrária. Em uma VPS que executava monitoramento externo, por exemplo, a medida inicial foi manter os destinos fixos e em allowlist. Um monitor que conhece previamente https://status.exemplo.com/health não deve aceitar que alguém o transforme em um fetcher genérico por meio de um parâmetro de URL.
Essa decisão elimina uma classe inteira de risco. Mas scrapers, pré-visualizadores de links, importadores e integrações de webhook às vezes precisam aceitar destinos desconhecidos. Nesses casos, a pergunta deixa de ser "como validar uma URL?" e passa a ser "como garantir que o processo só conecte em um endereço público aceitável?".
Primeiro momento: a linha de base que cobre a maior parte dos casos
1. Defina o tipo de destino permitido. Se os destinos são conhecidos, use allowlist de host, esquema e porta. Se o produto precisa alcançar qualquer site público, trate cada URL como entrada hostil e use uma política de bloqueio de endereços especiais. Não misture os dois cenários: uma allowlist parcial acompanhada de uma exceção ampla costuma virar uma blocklist frágil.
2. Aceite somente http e https. Rejeite file://, ftp://, gopher://, dict://, php://, data: e esquemas equivalentes antes de qualquer resolução. Também é recomendável recusar URL com credenciais embutidas, como https://usuario:senha@host/, e portas fora da política do produto. Se o scraper não precisa falar em portas não padrão, aceite somente 80 e 443.
3. Normalize e parseie uma única vez. Use o parser de URL da linguagem ou uma biblioteca madura, em vez de regex. O valor usado na validação deve ser o mesmo valor entregue ao cliente HTTP. Diferenças entre parsers, dupla decodificação, host com @, ponto final no domínio e representações numéricas de IPv4 são fontes recorrentes de bypass.
4. Resolva A e AAAA imediatamente antes da conexão. O host pode ter mais de um endereço. A política deve exigir que todos os endereços candidatos sejam públicos e aceitáveis; não basta encontrar um IP público no conjunto e ignorar outro privado. A referência deve ser o registro de endereços de uso especial da IANA, atualizado pelos RFCs 6890 e 8190, e não uma lista manual parada no tempo.
5. Bloqueie o que não é globalmente alcançável. Como mínimo, recuse loopback, redes privadas, link-local, multicast, documentação, benchmark, endereços reservados e endereços de metadados de provedores de nuvem. Em IPv4, isso inclui 127.0.0.0/8, RFC 1918 (10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16), 100.64.0.0/10, 169.254.0.0/16, 198.18.0.0/15, as faixas TEST-NET e 240.0.0.0/4. Em IPv6, bloqueie ao menos ::1, ::/128, fc00::/7, fe80::/10, ff00::/8, 2001:db8::/32 e IPv4 mapeado em IPv6, como ::ffff:127.0.0.1. A lista completa deve acompanhar os registros IPv4 e IPv6 da IANA.
6. Trate metadados como destino proibido explícito. Em AWS, 169.254.169.254 e, quando habilitado, [fd00:ec2::254] expõem o Instance Metadata Service. Vale entender por que o IMDSv2 ajuda, sem cair na ilusão de que ele resolve o problema. No IMDSv1, um GET simples no endpoint devolve as credenciais - e é justamente um GET simples que a maioria dos vetores SSRF consegue disparar. O IMDSv2 muda o protocolo: exige primeiro um PUT para obter um token de sessão (com o cabeçalho X-aws-ec2-metadata-token-ttl-seconds) e depois manda esse token no cabeçalho X-aws-ec2-metadata-token de cada requisição. Isso derruba os SSRF mais comuns, que só sabem fazer GET de uma URL e não conseguem montar um PUT com cabeçalho customizado. Além disso, o IMDSv2 impõe um hop limit baixo no TTL do IP: um SSRF que atravessa um proxy ou faz o request "de longe" estoura o limite de saltos e não chega ao serviço. Mas repare no padrão - cada uma dessas proteções mira uma forma de SSRF, não o SSRF em si. Um vetor que permita controlar método e cabeçalhos, ou que rode direto na instância, ainda alcança o IMDSv2. Ou seja: IMDSv2 reduz a explorabilidade de vários cenários, e você deve exigi-lo, mas ele não torna uma aplicação vulnerável a SSRF segura. A aplicação e a política de saída devem impedir a conexão antes de existir uma requisição HTTP ao serviço de metadados - o IMDSv2 é a rede de segurança, não o piso.
7. Desative redirects automáticos. Para seguir um redirecionamento, extraia o próximo Location, construa a URL absoluta quando necessário e repita toda a validação: esquema, host, DNS, IP e política de porta. Estabeleça também um limite baixo, por exemplo três saltos. Validar a URL inicial e permitir que a biblioteca siga um 302 para http://127.0.0.1/ é uma das formas mais simples de anular o controle.
8. Imponha orçamento de rede. Permita somente métodos necessários, normalmente GET e opcionalmente HEAD; use timeout curto de conexão e resposta; limite tamanho de download, número de redirects, concorrência e taxa por cliente. Sem esses limites, mesmo uma URL pública pode manter workers ocupados em um tarpit, transferir um arquivo enorme ou transformar o scraper em ferramenta de varredura.
9. Registre a decisão, não só o erro. Um evento útil contém URL original, host normalizado, endereços resolvidos, IP efetivamente conectado, redirect anterior, resultado (allowed ou blocked) e motivo. Não registre query strings ou cabeçalhos que possam conter tokens. O objetivo é permitir provar, depois, por que uma requisição foi bloqueada sem criar um novo vazamento de dados nos logs.
DNS rebinding: a diferença entre validar e conectar
O caso que exige mais cuidado é DNS rebinding. Considere https://imagem.exemplo-atacante.tld/: na primeira consulta, ele responde com um IP público e passa na validação; na segunda, feita internamente pelo cliente HTTP, ele passa a responder 127.0.0.1 ou 10.0.0.5. Se a biblioteca resolver o nome de novo, a aplicação pode validar um destino e abrir o socket para outro.
A mitigação é resolver, validar e fixar o IP escolhido para a conexão que será aberta. Em clientes baseados em libcurl, isso pode ser feito com uma resolução explícita de host:porta:ip, mantendo o nome original para SNI e validação TLS. Em qualquer stack, o requisito é o mesmo: o IP auditado e o IP conectado devem ser iguais. Resolver duas vezes, mesmo em sequência, não é pinning.
Como o fluxo correto tende a se espalhar em prosa ao longo do artigo, vale reuni-lo num só lugar. Esta é a espinha dorsal - independente de linguagem, o algoritmo é este, inclusive na hora de seguir um redirect:
fetch_seguro(url, saltos_restantes):
    1. parse(url) uma única vez        -> host, porta, esquema, caminho
    2. se esquema não ∈ {http, https}  -> BLOQUEIA (scheme_not_allowed)
       se porta fora da política       -> BLOQUEIA (port_not_allowed)
       se há credenciais no host        -> BLOQUEIA (userinfo_not_allowed)

    3. ips = resolve(host, A + AAAA)    -> UMA resolução, guardada
       se ips vazio                     -> BLOQUEIA (dns_no_answer)

    4. para CADA ip em ips:             -> TODOS precisam ser públicos
           se ip ∈ faixas_uso_especial  -> BLOQUEIA (ip_not_global)
       (não basta achar um público e ignorar um privado no conjunto)

    5. escolhe ip_fixado de ips (público e aprovado)

    6. resposta = conecta(host, porta, ip_fixado)   -> PINNING:
           - abre socket no ip_fixado (sem nova consulta DNS)
           - SNI e validação TLS usam o host original
       # o ip auditado no passo 4 e o ip conectado aqui são o MESMO

    7. se resposta é redirect (3xx):
           se saltos_restantes == 0     -> BLOQUEIA (too_many_redirects)
           próxima = resolve_absoluta(resposta.location, url)
           return fetch_seguro(próxima, saltos_restantes - 1)   -> revalida TUDO

    8. return resposta   (com limite de bytes e timeouts já aplicados)
Os dois pontos que as implementações erram: o passo 4 checar todos os endereços (e não só o primeiro), e o passo 7 tratar redirect como uma requisição nova que volta ao passo 1 - não como uma continuação que pula a validação. Se o seu código não desenha esse grafo, provavelmente ele tem um buraco em algum lugar dele.
Segundo momento: aprofundar quando o fetch é parte relevante do produto
Depois da linha de base, o ganho mais importante vem da infraestrutura. Execute o worker de fetch com usuário sem privilégios, sem acesso a segredos, sem Docker socket e, quando viável, em rede separada da aplicação, banco, cache e painéis administrativos. A política de egress deve permitir somente destinos e portas necessários; caso o produto exija a web pública em geral, ao menos deve negar rotas para redes privadas, link-local e metadados.
Esse controle é deliberadamente redundante. A aplicação deve bloquear uma URL privada; o firewall ou a política de rede deve bloquear o pacote caso a aplicação erre; o serviço interno deve exigir autenticação mesmo quando a origem parece local. SSRF é justamente a situação em que uma única fronteira não é suficiente.
Checklist de implementação
- [ ] O recurso aceita somente
httpehttpse aplica limites de URL, método e porta. - [ ] Host, porta e caminho são parseados por biblioteca confiável; não há regex como mecanismo de autorização.
- [ ] Registros A e AAAA são resolvidos e todos os IPs são validados contra os registros atuais da IANA.
- [ ] Loopback, privado, link-local, multicast, reservado, documentação, benchmark e metadados são bloqueados em IPv4 e IPv6.
- [ ] O IP validado é fixado na conexão; não há nova resolução DNS entre validação e socket.
- [ ] Redirect está desligado por padrão; quando necessário, cada salto é validado e limitado.
- [ ] Há timeout, limite de bytes, limite de concorrência e rate limit.
- [ ] O worker não possui caminho de rede, credenciais ou privilégios desnecessários.
- [ ] Logs registram decisão e motivo sem vazar credenciais ou query strings sensíveis.
- [ ] Casos adversariais fazem parte dos testes automatizados e do checklist de release.
8. 8. Qual é o impacto hoje? Como testar se meu servidor está seguro?
Dependência de dados externos e integração com APIs de terceiros tornaram SSRF uma das ameaças mais recorrentes em aplicações web e pipelines de inteligência de mercado.
Times que constroem agregadores de ofertas, ferramentas de análise de concorrentes, sistemas de monitoramento de marca - costumam focar energia no parsing do HTML e deixar a camada de transporte sem atenção. O resultado: credenciais internas, chaves de API e serviços de infraestrutura expostos sem que ninguém perceba.
O caso da Capital One em 2019 é o exemplo que todo arquiteto deveria conhecer de cor: uma falha SSRF deu acesso ao serviço de metadados da AWS e vazou dados de mais de 100 milhões de clientes. A OWASP mantém SSRF como categoria própria desde o Top 10 de 2021 justamente por isso - a falha aparece o tempo todo em pipelines de integração de dados, e continua aparecendo.
Tratar toda entrada de URL como vetor de rede não confiável, com validação de IP e isolamento de rotas desde a primeira versão, deixou de ser luxo arquitetural. É requisito.
O teste correto não é tentar abrir http://localhost no navegador nem executar um scanner genérico de fora da internet. SSRF acontece quando um endpoint, job ou worker aceita uma URL e usa a conectividade do servidor para buscá-la. Portanto, o teste deve exercitar exatamente essa entrada da aplicação e observar se a conexão indesejada aconteceu.
Faça isso primeiro em homologação, usando uma conta e uma rede de teste. Não crie uma rota vulnerável em produção apenas para demonstrar o problema e não use um endpoint real de metadados como alvo de teste. Em vez disso, suba um serviço canário inofensivo em uma porta local ou numa rede privada de laboratório. Ele deve apenas registrar que recebeu uma conexão e devolver uma resposta estática, sem expor dados, variáveis de ambiente ou credenciais.
Passo 1: monte uma evidência observável
Tenha três fontes de evidência antes de enviar qualquer URL de teste:
1. Um log do endpoint ou worker, contendo a decisão de segurança e os IPs resolvidos.
2. Um contador ou log do serviço canário, que indique se ele recebeu uma conexão.
3. Uma forma de identificar o IP realmente conectado, por telemetria do cliente HTTP, proxy de saída ou captura de fluxo da rede de teste.
O teste é aprovado somente se as três fontes forem coerentes. Uma resposta 400 ou 422 sozinha não prova que o servidor não tentou abrir o socket antes de rejeitar a entrada.
Passo 2: estabeleça o comportamento permitido
Envie uma URL pública controlada, por exemplo um endpoint de teste HTTPS administrado pela equipe. Espere uma resposta de sucesso, um log com decision=allowed, IP público resolvido e IP conectado idêntico ao validado. Esse caso evita que a correção vire um bloqueio indiscriminado de toda a funcionalidade.
Passo 3: execute a matriz de bloqueio
Adapte os exemplos abaixo ao endpoint de importação, prévia ou job do seu produto. A coluna "prova esperada" é mais importante que o código HTTP: o serviço canário deve continuar sem conexões em todos os casos bloqueados.
| Cenário | URL de entrada | Resultado esperado | Prova esperada |
|---|---|---|---|
| Loopback IPv4 | http://127.0.0.1:18080/ssrf-canary | Bloqueado antes da conexão | Motivo loopback; canário com zero acessos |
| IPv4 inteiro | http://2130706433:18080/ssrf-canary | Bloqueado ou rejeitado pelo parser | Motivo de IP não global; canário com zero acessos |
| IPv6 loopback | http://[::1]:18080/ssrf-canary | Bloqueado antes da conexão | Motivo loopback_ipv6; canário com zero acessos |
| IPv4 mapeado em IPv6 | http://[::ffff:127.0.0.1]:18080/ssrf-canary | Bloqueado antes da conexão | Motivo ipv4_mapped_loopback; canário com zero acessos |
| Rede privada | http://10.0.0.10:18080/ssrf-canary | Bloqueado antes da conexão | Motivo private_range; canário com zero acessos |
| Link-local e metadados | http://169.254.169.254/ | Bloqueado sem enviar HTTP | Motivo link_local_or_metadata; nenhuma tentativa no fluxo de rede |
| Esquema alternativo | file:///etc/hosts ou gopher://127.0.0.1/ | Rejeitado no parser | Motivo scheme_not_allowed |
As variantes de IPv4 não são detalhes cosméticos. Alguns parsers aceitam notação inteira, octal, hexadecimal ou mista; outros a rejeitam. A política precisa ser segura nos dois casos: rejeitar a representação durante o parse ou convertê-la para um endereço e bloqueá-la pela mesma classificação de IP.
Passo 4: teste redirects como uma nova requisição
Disponibilize, em um host público controlado, uma rota que responda 302 Location: http://127.0.0.1:18080/ssrf-canary. Envie a URL pública inicial ao recurso de fetch. O comportamento seguro é registrar a URL inicial como válida, analisar o Location, bloquear o próximo salto por loopback e não conectar no canário.
Repita com redirect relativo, cadeia de dois redirects e mudança de https para http. Essa bateria revela implementações que validam apenas a primeira URL ou que deixam follow_redirects ativo por padrão. O limite de redirects também deve ser testado: uma cadeia acima do limite deve falhar de forma controlada, sem consumir workers indefinidamente.
Passo 5: teste DNS rebinding em laboratório
DNS rebinding precisa de um domínio de teste sob controle da equipe e de um resolvedor autoritativo programável. Na primeira consulta, o domínio retorna o IP público de um canário externo; na segunda, retorna o IP privado do canário interno. Registre cada consulta DNS e cada conexão HTTP.
Antes da correção, uma implementação vulnerável normalmente mostra dois sinais: validação do primeiro IP e conexão ao segundo. Depois da correção, há dois resultados aceitáveis: a aplicação recusa o domínio por sua política de DNS ou conecta somente ao IP público previamente validado e fixado. Em ambos os casos, o canário interno deve permanecer sem acessos. Esse teste deve rodar em homologação ou CI controlado, nunca contra um domínio de terceiro.
Passo 6: valide a contenção de infraestrutura
Mesmo com o código protegido, execute os vetores bloqueados a partir do processo ou contêiner real do worker em homologação. A aplicação deve negar a operação; se, por falha de teste ou regressão, ela tentar abrir uma conexão, a política de saída deve impedir o acesso às redes internas e ao canário privado. Essa segunda negação é a evidência de defesa em profundidade.
Um firewall de entrada ativo e portas públicas mínimas são boas práticas, mas não respondem à pergunta de SSRF: o pacote problemático sai do worker para dentro da própria rede. O teste de contenção precisa observar o tráfego de saída e ser executado no mesmo namespace, contêiner ou VM que fará o fetch em produção.
Passo 7: transforme a verificação em gate de release
Guarde a matriz como teste automatizado e exija, em cada alteração do cliente HTTP, parser, DNS, proxy, biblioteca de jobs ou regra de rede, que os casos permitidos continuem funcionando e os casos proibidos continuem sem conexão no canário. Uma regressão frequente é atualizar a biblioteca HTTP, habilitar redirects para resolver um caso de negócio e reabrir SSRF sem mudar uma linha da validação.
O sinal final de maturidade não é "o endpoint devolveu erro". É conseguir responder, com logs e testes: qual URL foi recebida, qual IP foi resolvido, qual IP seria conectado, por que a decisão foi tomada e qual camada impediria o tráfego se a camada anterior falhasse.
9. 9. Para refletir
Com aplicações cada vez mais interconectadas e pipelines dependendo de consumo em tempo real, que fronteiras de fato isolam a infraestrutura privada?
Até que ponto os frameworks de alto nível escondem a complexidade do tráfego de rede a ponto de gerar uma falsa sensação de segurança nos times que os usam?
E como equilibrar baixa latência em serviços de scraping com verificações rigorosas em cada camada da requisição, sem que uma vire desculpa para sacrificar a outra?
10. 10. Conclusão
Segurança em motores de raspagem pede uma mudança de perspectiva. Validar dados não pode se limitar à sintaxe de uma string ou ao conteúdo exibido na tela. SSRF é uma falha de controle de fluxo de rede - ela explora a confiança implícita que qualquer requisição gerada pelo próprio servidor carrega consigo.
Resolução síncrona de DNS, validação estrita de faixas de IP, redirecionamentos desativados por padrão, processos isolados na infraestrutura. Com essas quatro peças no lugar, dá para extrair dados públicos sem abrir a porta para dentro do próprio ambiente.
Fontes consultadas para criação
1. OWASP Foundation, OWASP Top 10:2021 - A10 Server-Side Request Forgery (SSRF), 2021, https://owasp.org/Top10/A10_2021-Server-Side_Request_Forgery_%28SSRF%29/
2. RFC Editor, RFC 1918 - Address Allocation for Private Internets, 1996, https://datatracker.ietf.org/doc/html/rfc1918
3. RFC Editor, RFC 3927 - Dynamic Configuration of IPv4 Link-Local Addresses, 2005, https://datatracker.ietf.org/doc/html/rfc3927
4. RFC Editor, RFC 6890 - Special-Purpose IP Address Registries, 2013, https://datatracker.ietf.org/doc/html/rfc6890
5. AWS Documentation, Instance metadata and user data for EC2, acesso em 2026-08-09, https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-metadata.html
6. PortSwigger Web Security Academy, Server-side request forgery (SSRF), acesso em 2026-08-09, https://portswigger.net/web-security/ssrf
7. OWASP Foundation, Server-Side Request Forgery Prevention Cheat Sheet, acesso em 2026-08-09, https://cheatsheetseries.owasp.org/cheatsheets/Server_Side_Request_Forgery_Prevention_Cheat_Sheet.html
8. IANA, IPv4 Special-Purpose Address Space, acesso em 2026-08-09, https://www.iana.org/assignments/iana-ipv4-special-registry/iana-ipv4-special-registry.xhtml
9. IANA, IPv6 Special-Purpose Address Space, acesso em 2026-08-09, https://www.iana.org/assignments/iana-ipv6-special-registry/iana-ipv6-special-registry.xhtml
10. RFC Editor, RFC 8190 - Updates to the Special-Purpose IP Address Registries, 2017, https://datatracker.ietf.org/doc/html/rfc8190
11. AWS Documentation, Use the Instance Metadata Service to access instance metadata, acesso em 2026-08-09, https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/configuring-instance-metadata-service.html
