1. Resumo executivo
Quando um assistente de IA recebe uma tarefa em um projeto real, a primeira coisa que ele faz, antes de escrever qualquer linha, é procurar contexto. Ele varre pastas, abre arquivos, segue imports, tenta adivinhar onde estão a tabela, a rota, o controller e o método que a tarefa toca.
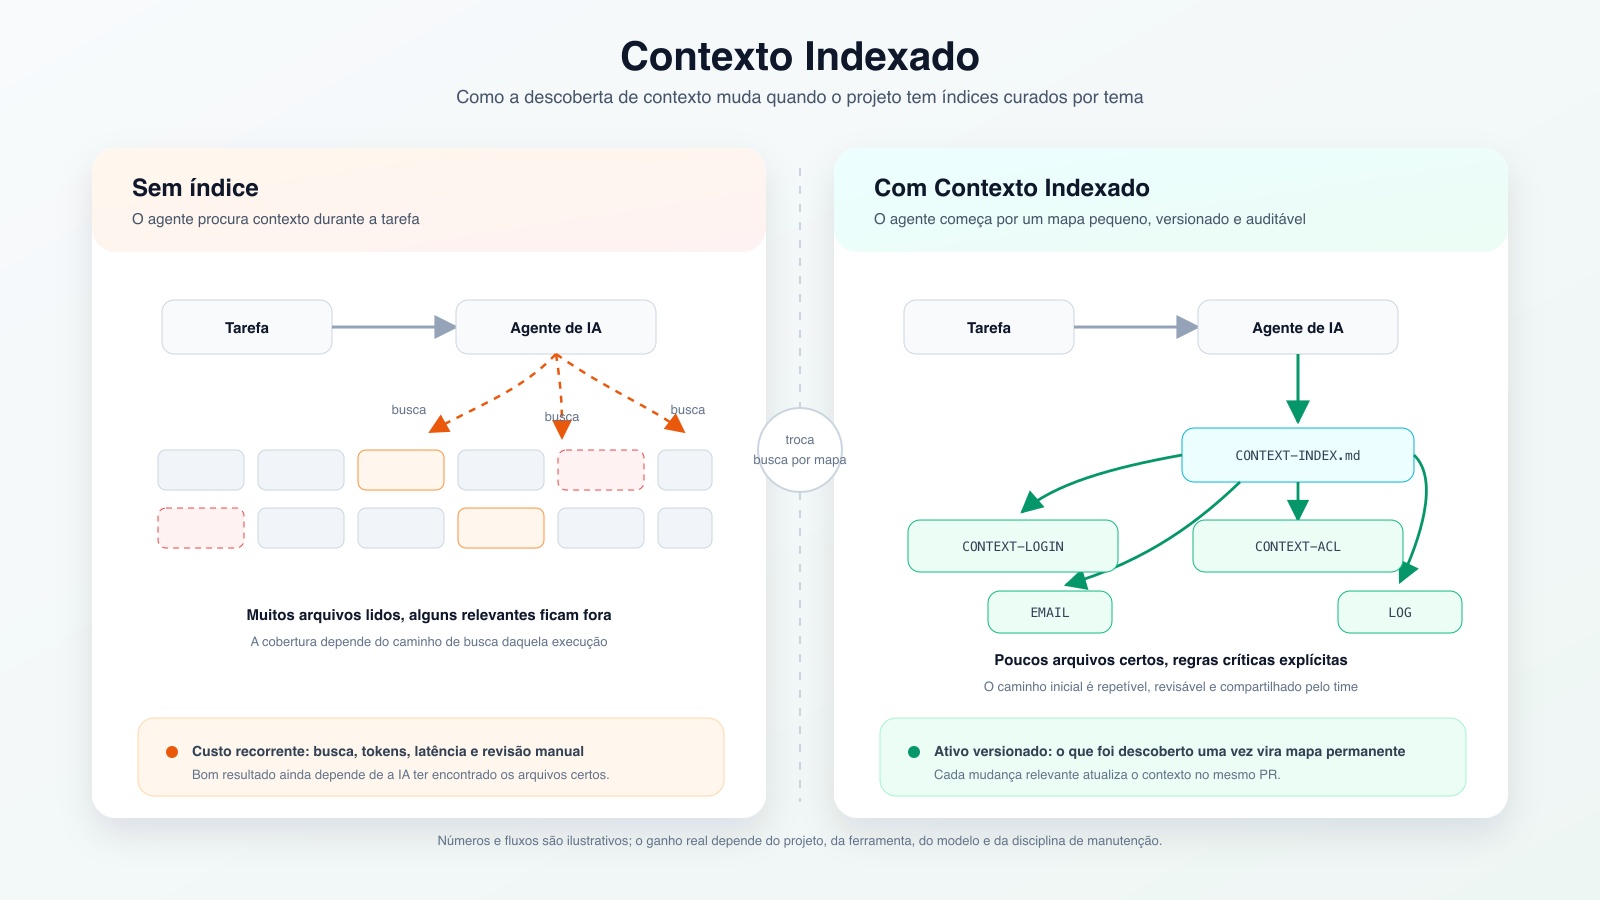
Essa etapa é invisível, mas não é gratuita. Ela consome tempo, consome tokens (créditos) e, o mais grave, não é confiável: dependendo do modelo, do tamanho do projeto e do esforço de busca, a IA pode pular arquivos importantes e mesmo assim seguir em frente como se tivesse o quadro completo.
Propor uma metodologia simples para dar contexto a assistentes de IA em projetos de software é o objetivo central desta abordagem: em vez de deixar a IA procurar arquivos relacionados a cada tarefa, o time cura antecipadamente pequenos índices por tema, os arquivos de contexto, que apontam para o que já existe no código. A metodologia serve a projetos novos, mas foi pensada principalmente para plataformas que já estão em produção e estão começando a usar IA no desenvolvimento.
Contexto não deveria ser descoberto de novo a cada tarefa. Descoberto uma vez e indexado, ele deixa de ser uma busca cara e não-determinística e passa a ser um ativo versionado do projeto, compartilhado entre pessoas, equipes e IAs.
IMPORTANT
A busca de contexto sem índice é probabilística e consome créditos a cada execução. O Contexto Indexado transforma a descoberta em um ativo determinístico, curto e reutilizável.
2. O custo e os limites da busca de contexto
O custo da busca na hora
A busca de contexto feita na hora tem quatro custos concretos:
- Custo financeiro. Cada varredura de arquivos consome tokens de entrada. Em projetos grandes, a maior parte do gasto de uma tarefa pode estar na fase de procurar, não na de resolver.
- Custo de latência. Abrir, ler e descartar dezenas de arquivos até encontrar os certos é lento.
- Custo de confiança. Você não tem como saber se a IA realmente viu tudo o que precisava. Ela raramente diz "não achei o arquivo X"; ela simplesmente trabalha com o que encontrou.
- Custo de repetição. Na próxima tarefa sobre o mesmo assunto, todo o trabalho de descoberta é refeito do zero.
Para dar ordem de grandeza (números ilustrativos; o valor real varia por projeto, modelo e ferramenta): em uma base de código média, resolver uma tarefa pode envolver ler de 30 a 60 arquivos na fase de descoberta, algo entre 40 mil e 120 mil tokens de entrada. E esse gasto se repete a cada tarefa parecida. Com um índice curado, a mesma fase cai para a leitura de um arquivo de 1 a 2 mil tokens mais os 4 a 6 arquivos certos. A economia é de uma ordem de grandeza, por tarefa.
O ponto mais perigoso, porém, é o custo de confiança. Uma IA que trabalha com contexto parcial não parece estar com contexto parcial: ela produz código plausível, com a mesma fluência de sempre. O erro só aparece depois, quando ela ignora uma regra de negócio que estava em um arquivo que ela nunca abriu.
O loop do agente e os limites de contexto
Para entender onde a metodologia atua, vale abrir a caixa e ver como essas ferramentas funcionam por dentro.
Modelos de linguagem não têm memória entre chamadas. Tudo o que o modelo "sabe" sobre o seu projeto durante uma tarefa é o que está na janela de contexto daquela conversa: as instruções, o histórico e os arquivos que foram lidos. A janela é finita (por exemplo, 200 mil tokens) e tudo o que entra nela custa dinheiro e espaço.
As ferramentas de IA para código (Claude Code, Cursor, Copilot e similares) operam em um loop de agente: o modelo decide uma ação (listar um diretório, buscar uma palavra, ler um arquivo), recebe o resultado dentro da janela, e decide a próxima ação. A fase de descoberta é uma sequência de apostas: cada decisão de "onde olhar" vem de heurísticas gerais aprendidas no treinamento, não do conhecimento real do seu repositório.
Três limites estruturais desse fluxo criam o gap que nos interessa:
1. Orçamento implícito de esforço. O loop precisa parar de procurar em algum momento. O modelo julga "já tenho o suficiente" de forma probabilística, e modelos menores, mais rápidos ou configurados para menos esforço param antes. É exatamente aqui que arquivos relevantes são pulados.
2. Atenção diluída. Nem tudo o que entra na janela é lido com o mesmo peso. Informação enterrada no meio de contextos muito longos tende a receber menos atenção (efeito conhecido na literatura como "lost in the middle"). Despejar o repositório inteiro no contexto não resolve o problema, mesmo quando cabe.
3. Nenhum oráculo de completude. Nada no loop garante "você já viu tudo o que importa". O agente não sabe o que não sabe: ele segue confiante com o mapa parcial que montou.
O resultado: entre "tarefa recebida" e "primeira linha editada" existe uma fase não-auditável, não-reproduzível e cara. Rodar a mesma tarefa duas vezes pode percorrer caminhos de descoberta diferentes e chegar a conclusões diferentes.
3. A metodologia do Contexto Indexado
O conceito e os três princípios
A proposta é inverter a ordem. Em vez de a IA descobrir o contexto a cada tarefa, o time cura o contexto uma vez e o guarda em arquivos pequenos e objetivos, organizados por tema relacional.
Cada arquivo é um índice, não uma nova documentação. Ele não reescreve o que o código faz; ele aponta para onde as coisas estão e registra o que a IA precisa saber para não errar:
- qual é o propósito do módulo;
- qual é o fluxo principal;
- quais são os pontos críticos que nunca devem ser violados;
- quais tabelas, rotas, arquivos e métodos estão envolvidos.
Chamamos essa prática de Contexto Indexado: um conjunto de arquivos CONTEXT-*, um por assunto, mais um índice-mestre CONTEXT-INDEX.md, que funcionam como o mapa que a IA consulta antes de agir.
Três princípios definem um bom arquivo de contexto:
1. Curto e objetivo. Se virar um documento longo, deixa de ser índice e ninguém mantém.
2. Aponta, não duplica. Ele lista o AuthController::login(), não copia o código dele.
3. Verificável. Só entra no índice o que existe de fato no projeto. Nada de tabela, rota ou método inventado.
Catálogo sugerido de contextos
Não existe lista fechada; cada projeto tem seus temas. Mas há um conjunto recorrente que serve de ponto de partida na maioria dos sistemas:
- Infra e fluxo: API, URL, WEBHOOK, CRON, PUSH, CACHE, LOG.
- Segurança e acesso: LOGIN, ACL, TOKEN, SECURITY.
- Dados e persistência: MIGRATION, CRUD, UPLOAD.
- Interface: FORM, COMPONENT, CSS, ICON.
- Entrega: BUILD, CI-CD, TEST, RELEASE, GIT.
- Comunicação: EMAIL.
A regra prática: se um assunto tem regras próprias e um conjunto identificável de arquivos, ele merece o próprio contexto. Comece pelos temas mais tocados no dia a dia e cresça o catálogo conforme a necessidade.
4. Anatomia e exemplo prático de um arquivo de contexto
As sete seções fundamentais
Cada arquivo segue a mesma estrutura de sete seções. A uniformidade é proposital: a IA aprende o formato uma vez e passa a ler qualquer contexto com a mesma velocidade.
1. Overview: propósito do módulo, entidades principais e regras de negócio centrais.
2. Fluxo principal: a sequência de operações do gatilho à conclusão, numerada.
3. Pontos críticos: invariantes, restrições e armadilhas que a IA nunca deve violar.
4. Tabelas envolvidas: tabelas do banco e para que servem.
5. Rotas envolvidas: endpoints, o controller/ação que respondem e o nível de acesso.
6. Arquivos envolvidos: os arquivos-chave e o papel de cada um.
7. Métodos envolvidos: métodos relevantes e o comportamento de cada um.
As seções 4 a 7 são o coração do índice: são elas que respondem, em segundos, à pergunta que a IA gastaria créditos para responder sozinha: "onde estão as peças deste assunto?".
Dois complementos tornam o conjunto navegável e confiável:
- Índice-mestre. Um
CONTEXT-INDEX.mdlista todos os contextos existentes, com uma linha de resumo cada. É o ponto de entrada único: a IA descobre o que existe lendo um arquivo, sem varrer pasta. - Marca de frescor. O cabeçalho de cada contexto registra a data e o commit da última revisão (por exemplo,
Last revised: 2026-07-04 | Commit: a1b2c3d). Isso permite medir a defasagem: basta comparar o commit do contexto com o histórico dos arquivos da área.
No repositório, os contextos vivem em uma pasta própria (por exemplo, ai/context/), versionados junto com o código que descrevem.
Exemplo real: CONTEXT-LOGIN
Para sair da teoria, veja um arquivo de contexto preenchido para o módulo de autenticação de um sistema web típico.
# CONTEXT-LOGIN - Autenticação de Usuário

> Version: 1.0 | Last revised: 2026-07-04 | Commit: a1b2c3d

## 1. Overview
Módulo responsável por autenticar usuários por e-mail e senha, criar a sessão autenticada e emitir o token de acesso. Entidade principal: usuário (`tb_user`). Regra central: apenas usuários com status `active` podem autenticar; senha é verificada contra hash, nunca em texto puro.

## 2. Fluxo principal
1. Usuário envia e-mail e senha em `POST /login`.
2. `AuthController::login()` valida o formato dos campos.
3. `AuthService::authenticate()` busca o usuário e confere o hash da senha.
4. Se o status não for `active`, o acesso é negado.
5. Em caso de sucesso, a sessão é criada e um token de acesso é emitido.
6. A tentativa (sucesso ou falha) é registrada (ver CONTEXT-LOG).

## 3. Pontos críticos
- Nunca comparar senha em texto puro; sempre usar o hash.
- Não revelar se o e-mail existe: mensagem de erro genérica em falha.
- Usuário `inactive` ou `blocked` nunca autentica, mesmo com senha correta.
- Toda tentativa de login deve gerar registro de auditoria.
- Limite de tentativas por IP antes de bloqueio temporário.

## 4. Tabelas envolvidas
| Table | Description |
|---|---|
| `tb_user` | Usuários; colunas-chave: email, password_hash, status |
| `tb_login_attempt` | Auditoria de tentativas de login (ver CONTEXT-LOG) |

## 5. Rotas envolvidas
| Route | Controller::Action | Access |
|---|---|---|
| `POST /login` | `AuthController::login()` | Público |
| `POST /logout` | `AuthController::logout()` | Autenticado |

## 6. Arquivos envolvidos
| File | Role |
|---|---|
| `app/Http/Controllers/AuthController.php` | Recebe e valida a requisição |
| `app/Services/AuthService.php` | Verifica credenciais, hash e status |
| `app/Models/User.php` | Modelo do usuário e regras de negócio |

## 7. Métodos envolvidos
| Method | Description |
|---|---|
| `AuthController::login()` | Orquestra o fluxo de autenticação |
| `AuthService::authenticate()` | Confere hash e status; retorna sucesso/erro |
| `User::isActive()` | Regra de usuário apto a autenticar |
Em menos de uma página, a IA sabe onde estão todas as peças da autenticação, quais regras não pode violar e para quais outros contextos deve olhar. Nenhum crédito foi gasto procurando: o mapa já estava pronto.
Cruzando múltiplos contextos
Poucas tarefas vivem dentro de um único assunto. Adicionar autenticação em dois fatores (2FA), por exemplo, toca várias áreas ao mesmo tempo:
- CONTEXT-LOGIN: onde o fluxo de autenticação será interrompido para pedir o segundo fator;
- CONTEXT-ACL: quais perfis passam a ser obrigados a usar 2FA;
- CONTEXT-EMAIL: o envio do código, se o segundo fator for por e-mail;
- CONTEXT-LOG: auditoria de sucesso, falha e bloqueio.
Com os índices prontos, o desenvolvedor pode simplesmente pedir "implemente 2FA usando os contextos LOGIN, ACL, EMAIL e LOG", e a IA parte já com o mapa completo das quatro áreas. Sem os índices, a mesma tarefa exigiria uma longa e incerta fase de descoberta em quatro frentes, justamente onde arquivos costumam ser pulados.
É aqui que a metodologia mais compensa: quanto mais transversal a tarefa, maior a economia e a confiança.
5. Comparativo com outras abordagens de contexto
A objeção natural: "já existem formas de dar contexto à IA". Existem, e cada uma resolve um problema diferente.
- README e wikis. Escritos para humanos em onboarding. São prosa, envelhecem rápido e não mapeiam tabelas, rotas e métodos por tema. Na prática, o agente raramente os consulta no meio de uma tarefa.
- CLAUDE.md, AGENTS.md e arquivos de regras. Excelentes para convenções globais (estilo, comandos, padrões do repositório). Mas são carregados em toda sessão, o que os obriga a ser curtos; não escalam para mapear uma plataforma inteira. As variantes com escopo por pasta ou glob (regras por diretório,
CLAUDE.mdaninhados) chegam mais perto, carregando convenções por área sob demanda - mas seguem sendo arquivos de convenção: não mapeiam tabelas, rotas e métodos nem registram as invariantes de negócio de cada tema. São complementares ao Contexto Indexado: o arquivo de regras global serve como a instrução de entrada que direciona a IA para a metodologia (por exemplo, adicionando a regra: "Antes de propor qualquer alteração, consulteCONTEXT-INDEX.mdpara identificar e carregar os contextos temáticos da tarefa"), e os contextos entram sob demanda, conforme o tema da tarefa. - RAG e embeddings. Recuperação probabilística por similaridade. O RAG opera de "baixo para cima" (busca trechos de código isolados por similaridade matemática/semântica), o que gera ruído, perde a visão estrutural e corre o risco de ignorar o arquivo mais importante caso a consulta não bate com os termos exatos. Já o Contexto Indexado opera de "cima para baixo" (um mapa arquitetural e de regras de negócio curado por humanos). Além disso, o RAG exige infraestrutura de indexação e servidores de busca, enquanto o Contexto Indexado é determinístico, versionado e roda localmente sem custo ou latência adicionais.
- Mapas automáticos (ctags, árvore de diretório, resumos gerados). Dizem o que existe, não o que importa. Não carregam pontos críticos, invariantes nem fluxo de negócio.
Nenhuma dessas abordagens compete com a proposta; o Contexto Indexado ocupa uma lacuna específica entre as regras globais e o código bruto: o mapa temático, curado, com as regras críticas de cada área.
6. Adoção incremental e criação assistida por IA
Estratégia para sistemas em produção
A metodologia ajuda projetos novos, mas o maior ganho está nos sistemas que já estão em produção e estão começando a usar IA no desenvolvimento. São exatamente os projetos onde a IA mais se perde: código acumulado por anos, convenções implícitas, regras de negócio espalhadas e ninguém com o quadro inteiro na cabeça.
Nesses projetos, a adoção deve ser incremental, não um mutirão de documentação:
1. Comece pelo que dói. Crie primeiro os contextos das áreas onde a IA mais erra ou onde as mudanças são mais frequentes (muitas vezes LOGIN, ACL e o núcleo do domínio).
2. Um contexto por vez. Cada arquivo é curto; dá para criar um por dia, ou um antes de cada tarefa relevante.
3. Aproveite o trabalho já feito. Quando a IA termina de analisar um módulo para resolver uma tarefa, essa descoberta vira um arquivo de contexto - a própria IA gera o rascunho. O gasto de descoberta se transforma em ativo permanente.
4. Versione junto com o código. Os arquivos de contexto vivem no repositório e evoluem com ele. Uma mudança que altera uma rota ou tabela também atualiza o contexto correspondente.
O resultado é uma base que fica mais fácil de trabalhar a cada tarefa, em vez de exigir a mesma redescoberta cara indefinidamente.
Geração e atualização assistidas por IA
A objeção mais comum de qualquer gestor ou desenvolvedor ao ler esta proposta é imediata: "ninguém no meu time tem tempo para escrever e manter arquivos de contexto à mão".
E a objeção está certa. Se o processo fosse puramente manual, a metodologia nasceria morta pela fadiga de documentação. A virada está em quem faz o trabalho braçal: o time não escreve os contextos do zero; a própria IA os escreve, de forma assistida.
1. Geração inicial. Quando o desenvolvedor conclui uma tarefa em uma área que ainda não possui índice, ele pede ao assistente: "gere o rascunho do CONTEXT-MÓDULO.md desta área com base no código que você acabou de ler e no template padrão do projeto". A IA produz o arquivo em segundos.
2. Atualização contínua. Ao alterar uma rota, método ou tabela, a própria IA reescreve a seção correspondente do contexto e atualiza a marca de frescor antes de enviar o pull request.
3. O papel do humano. O desenvolvedor atua como curador e revisor: valida os caminhos das referências e confere se as regras de negócio declaradas estão corretas antes de commitar.
A IA assume o trabalho pesado de catalogação e digitação; o humano assume a supervisão e o controle de qualidade. É exatamente esse fluxo assistido que a Daggadol ajuda a estruturar nos times de engenharia.
7. Governança entre equipes, limitações e mitigações
Memória organizacional compartilhada
Em plataformas mantidas por várias equipes e departamentos, ninguém tem o mapa completo na cabeça. Cada equipe conhece profundamente a própria área e superficialmente as vizinhas. É nesse cenário que o Contexto Indexado deixa de ser uma otimização de custo e vira infraestrutura de alinhamento.
O crescimento é orgânico: cada equipe cria e mantém os contextos das áreas que domina, e o CONTEXT-INDEX.md agrega tudo em um catálogo compartilhado. Humanos e IAs de todas as equipes passam a trabalhar com a mesma informação, alinhada e auditável.
Na prática, isso ataca quatro dores clássicas de sistemas grandes:
- Erros de impacto indireto. A equipe A altera um serviço do qual um fluxo da equipe B depende. Se o contexto de B declara essa dependência, quem for mexer (pessoa ou IA) carrega os dois mapas e enxerga o impacto antes do estrago.
- Regras novas que poucos conhecem. Uma invariante criada na semana passada entra no contexto no mesmo PR que a criou. Deixa de viver apenas na cabeça de quem estava na reunião.
- Regras antigas que quase ninguém lembra. Aquela restrição de cinco anos atrás, conhecida por duas pessoas (uma delas já saiu da empresa), vira ponto crítico registrado e permanente.
- A cascata de arquivos. O encadeamento confuso onde o controller chama o service, que chama o helper, que dispara o job, mapeado uma vez no contexto em vez de redescoberto por cada pessoa e cada IA que precisa tocar nele.
A governança mínima para sustentar isso cabe em uma frase: quem altera a área atualiza o contexto no mesmo PR, e a revisão de código passa a incluir o diff do contexto. Com essa regra, os índices não defasam; sem ela, defasam em silêncio - e parte dessa checagem pode ser automatizada no CI. O efeito acumulado é que os contextos se tornam a memória organizacional do sistema, compartilhada entre equipes e entre humanos e IAs.
Limitações, riscos e automação via CI/CD
O Contexto Indexado tem custos e riscos próprios, e vale encará-los com honestidade técnica:
- O perigo do determinismo cego. O valor central da metodologia é o determinismo: garantir que a IA sempre olhe para os mesmos arquivos certos. Mas determinismo sobre dados defasados significa errar de forma determinística - e um mapa desatualizado é pior que mapa nenhum. Se o contexto diz que a rota de autenticação é X e ela mudou para Y na semana passada, a IA seguirá usando X com toda a confiança.
- Fadiga de manutenção. Sem disciplina de processo, a documentação morre. Se a equipe aprova pull requests que alteram o código e deixam os contextos para trás, em poucos meses os índices viram ruído.
- Custo inicial de implantação. Embora a IA gere os rascunhos, o alinhamento sobre o catálogo de contextos e a curadoria das primeiras regras críticas exigem tempo de discussão do time.
Duas defesas tornam a metodologia sustentável a longo prazo:
1. Validação automatizada (self-enforcing docs). Por serem altamente estruturados, os contextos podem ser conferidos por scripts simples em git hooks (pré-commit) ou no pipeline de CI/CD: o script verifica se as tabelas, rotas, arquivos e métodos listados em cada contexto de fato existem no código. Se um desenvolvedor remove um método e esquece o índice, a build quebra. O limite dessa defesa é conhecido: ela garante integridade referencial, não frescor semântico - uma regra de negócio que mudou ou uma invariante que ninguém registrou passam pelo script. Por isso a revisão humana do diff do contexto continua obrigatória.
2. Marca de frescor. O commit e a data no cabeçalho permitem cruzar o histórico do Git da área e identificar contextos que ficaram para trás desde a última revisão.
8. Como a Daggadol pode ajudar
A Daggadol auxilia organizações no planejamento, arquitetura e governança da adoção de Inteligência Artificial para desenvolvimento de software e operações digitais.
Ajudamos sua equipe a:
- estruturar a metodologia do Contexto Indexado e a governança de ativos de contexto no repositório;
- implementar pipelines de desenvolvimento assistido com geração e atualização automática de índices;
- definir estratégias de caching semântico e gerenciamento da janela de contexto para otimizar custos e acurácia;
- capacitar desenvolvedores e lideranças técnicas na criação e curadoria assistida de contextos temáticos.
Se você deseja implantar o Contexto Indexado e otimizar a eficiência da IA no seu time, entre em contato conosco.
9. Conclusão
A IA no desenvolvimento não falha apenas por falta de capacidade. Ela falha, muitas vezes, por trabalhar com contexto incompleto. O Contexto Indexado troca a adivinhação recorrente por um mapa curado e versionado. A mudança é pequena no formato, mas grande no efeito: menos descoberta repetida, mais previsibilidade, melhor auditoria e um caminho mais claro para humanos e IAs trabalharem sobre a mesma base.
Em projetos novos, ele organiza desde cedo. Em projetos já em produção, ele reduz o custo de mexer em sistemas que carregam anos de decisões, atalhos e regras implícitas.
10. Sobre a Daggadol
A Daggadol ajuda empresas a adotar IA no desenvolvimento de software com segurança e eficiência, incluindo a implantação do Contexto Indexado em plataformas que já estão em produção. Se quiser levar essa abordagem para o seu time, fale com a gente.
